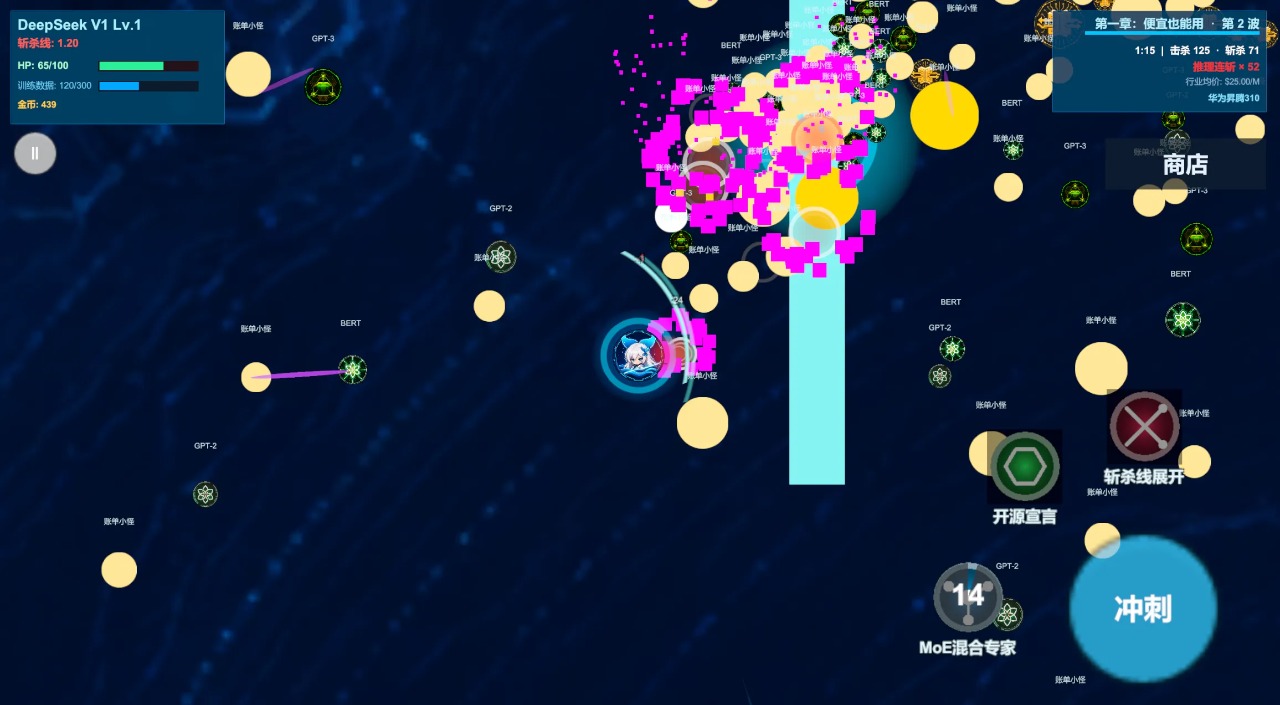
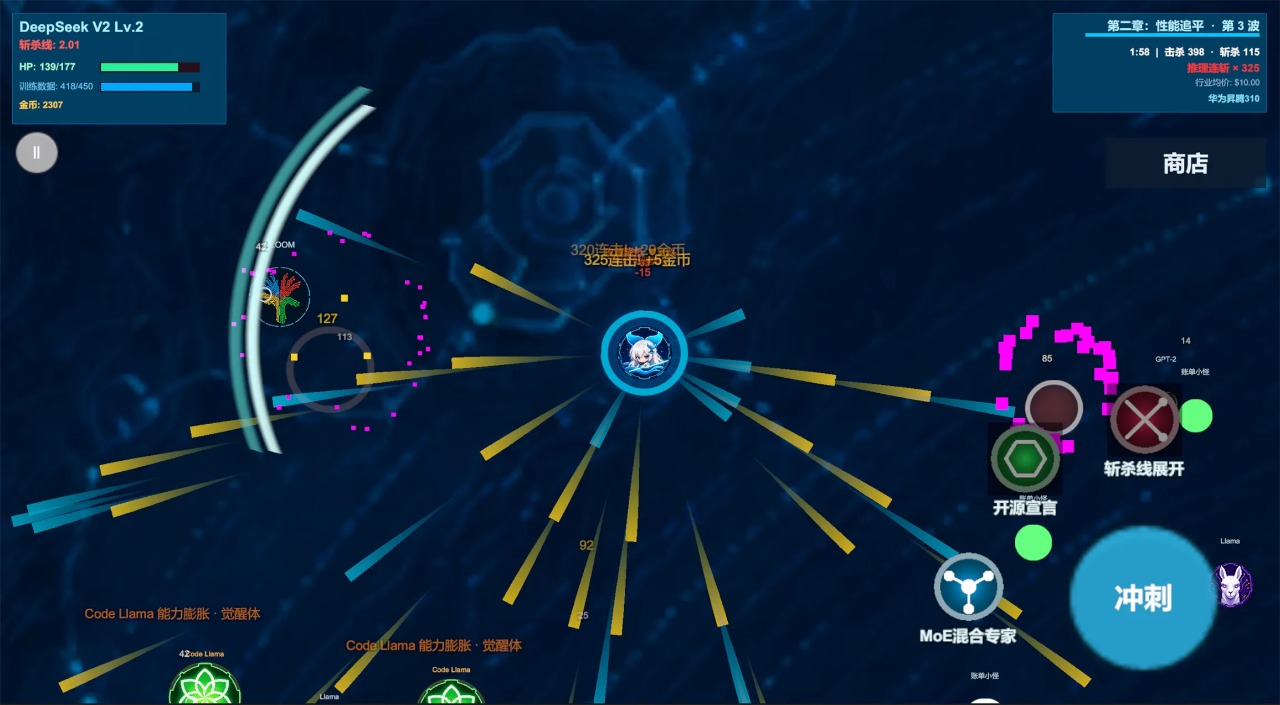
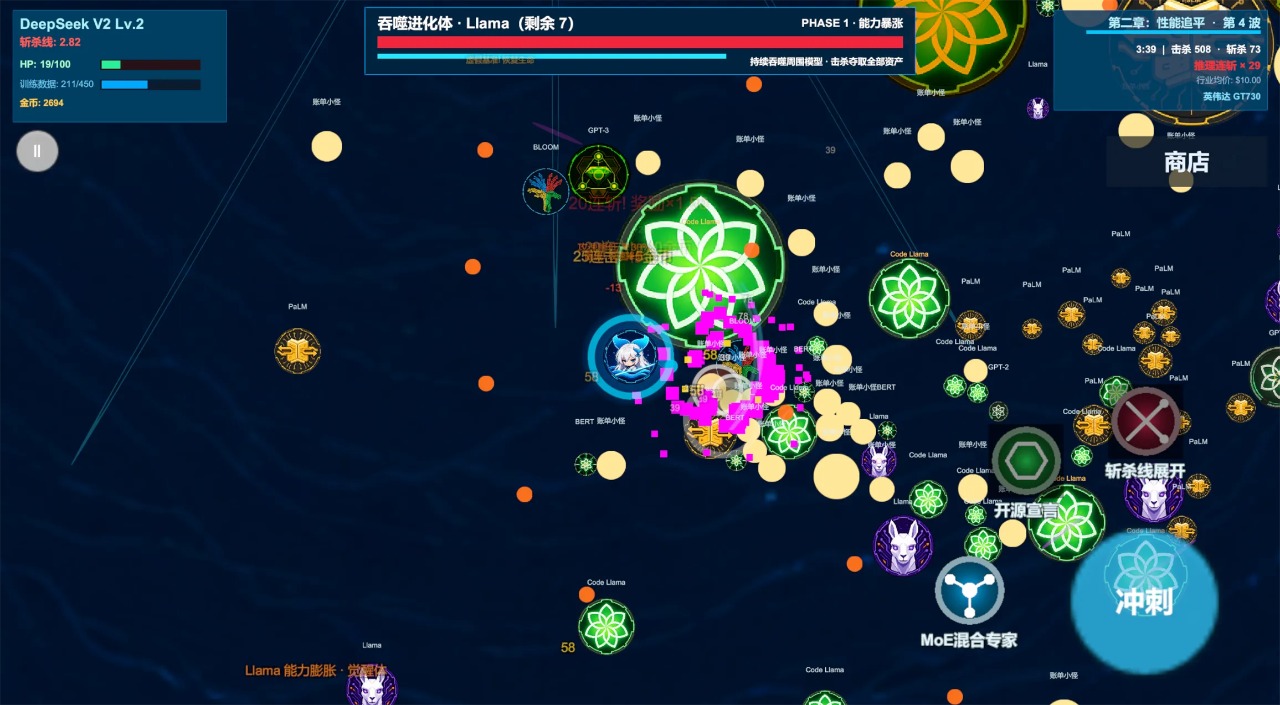
模型斩杀线是一款专为AI大模型性能评估与对比而设计的实用工具,它以独特的“斩杀线”概念为核心,帮助开发者、研究者和技术爱好者快速判断不同模型在特定任务上的能力边界。通过直观的基准测试与可视化图表,用户可以轻松识别出当前模型是否达到所谓的“及格线”或“斩杀线”,从而在模型选型、优化和部署中做出更明智的决策。软件操作简便,数据解析精准,输出报告详尽,是AI领域不可或缺的效率利器。
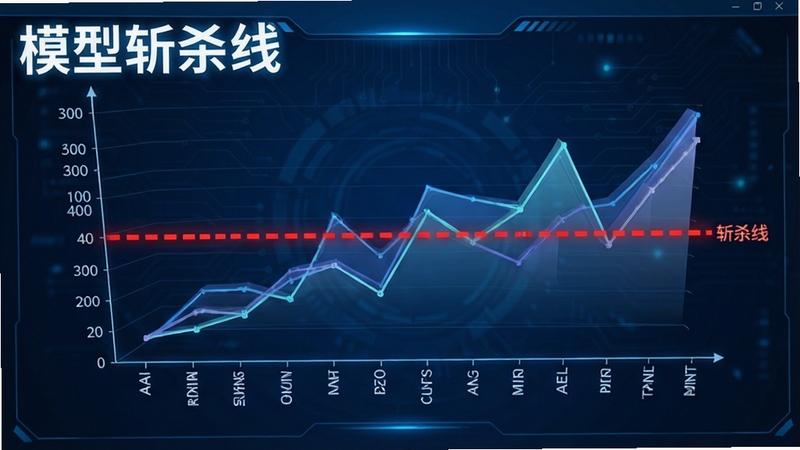
内置多维度基准测试集,涵盖逻辑推理、代码生成、数学解题、多轮对话等多种任务场景。用户只需选定待测模型与测试项目,软件即可自动运行评测,快速计算出模型在各任务上的得分,并与“斩杀线”阈值进行比对,清晰标注“通过”或“未通过”状态,让模型能力一目了然。
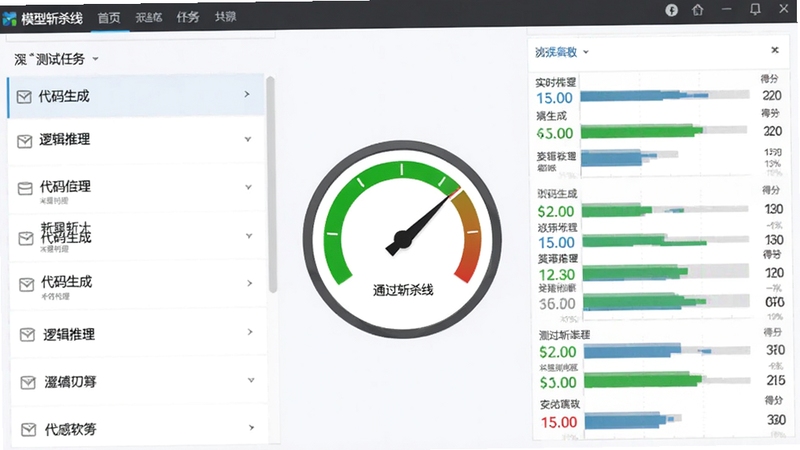
支持同时导入多个AI模型进行横向对比,以雷达图、柱状图等形式直观呈现不同模型在各能力维度上的优劣差异。通过对比,用户可以迅速发现哪个模型综合实力最强,哪个模型在特定任务上存在短板,从而在模型选型时避开“踩坑”风险,找到真正适合自身业务需求的“最优解”。
测试完成后,软件会自动生成一份详尽的可视化测试报告,包含各项得分、斩杀线达标情况、性能排名以及优化建议。报告支持导出为PDF或图片格式,方便用户将其用于团队分享、项目汇报或技术文档编写,大大提升了工作效率和专业形象。
考虑到企业用户对数据隐私的严格要求,模型斩杀线提供完全本地化的运行模式。用户的模型权重文件与测试数据均在本地设备上处理,无需上传至云端服务器,从根源上杜绝了数据泄露风险,确保敏感信息的安全性与私密性。
软件适配主流的深度学习框架,如PyTorch、TensorFlow、ONNX Runtime等,用户无需转换模型格式即可直接进行性能评估。同时,软件还支持从Hugging Face等模型库中直接拉取模型列表,大大简化了测试前的准备工作流程。
| 软件名称 | 核心优势 | 评分 |
|---|---|---|
| AI模型性能测试 | 多维度评测,结果精准 | ★★★★☆ |
| 大模型对比工具 | 支持多模型横向比较 | ★★★★☆ |
| AI能力评估平台 | 云端测试,无需安装 | ★★★★★ |
| LLM斩杀线测试 | 轻量级,适合快速评测 | ★★★★☆ |
| 模型定级评测神器 | 一键生成专业报告 | ★★★★★ |
| AI基准测试工具箱 | 集成多种测试集 | ★★★★☆ |
斩杀线理论最初源于游戏术语,指在战斗中能够一击击败对手的血量阈值。在AI大模型领域,这一概念被引申为衡量模型性能是否达到可接受底线的关键指标。简单来说,如果一个模型在特定任务上的得分低于斩杀线,则意味着该模型在此任务上的表现不足以满足实际应用需求,应当被淘汰或需要进一步优化;反之,如果得分高于斩杀线,则证明模型具有一定的实用价值。这一理论为模型选型提供了量化标准,避免了主观判断的随意性,帮助研发团队快速筛选出性能达标的模型,节省大量时间与计算资源。
第一步,准备测试数据集:从公开基准测试集(如MMLU、HumanEval等)中选取与你的应用场景相关的任务,或者使用自己的私有数据集进行测试。第二步,运行模型斩杀线软件:将待测模型导入软件,选择对应的测试任务,点击“开始测试”,软件会自动完成推理计算并输出得分。第三步,对比斩杀线阈值:软件会预先显示该任务的斩杀线参考值,将模型得分与之对比,若高于红线则通过,低于则未通过,整个过程无需复杂编码,即使是初学者也能快速上手。
模型斩杀线图通常以二维坐标图呈现,横轴代表不同的测试任务或模型版本,纵轴代表性能得分。图中会绘制一条水平红线,即为斩杀线。每个模型或任务对应的得分以柱状图或折线图形式展示。当柱状图高度超过红线时,表示该模型在此项任务上达标;反之,则未达标。通过观察图表,用户能迅速定位模型的薄弱环节,从而有针对性地进行改进或选择其他替代模型。
模型斩杀线作为一款评估工具,其评测结果基于公开的基准测试集与标准化流程,具有较高的客观性与可重复性,能够为技术决策提供有力参考。软件本身为纯本地运行,无需网络连接,不收集任何用户数据,因此在安全性上完全值得信赖。不过,任何评测工具都存在一定的局限性,斩杀线阈值并非绝对权威,用户应结合自身业务场景,综合考量模型的实际表现,切勿盲目迷信单一指标。


 OnePlus_15
 智愈MedSeek AI医生专属大模型下载官方安卓版v2.3.1最新免费版
智愈MedSeek是一款专业AI医生问诊软件,基于专属大模型提供智能导诊、症状自查、健康科普等服务,支持安卓手机随时使用,帮助用户快速了解病情,合理就医,是您贴
 Minis多模型AI助手下载免费安卓版v0.22-preview官方正版
Minis多模型AI助手是安卓平台上一款聚合了主流大模型的AI对话应用,支持文本创作、翻译、编程辅助与知识问答等功能,一个应用即可轻松体验多种AI模型魅力,是您移
 WatchDog AI大模型软件下载安卓免费版v1.8.0官方正版
WatchDog AI大模型软件是一款专为AI开发者打造的安卓端API额度与信用余额监控工具,支持多平台密钥管理、超额预警、用量统计,帮助您实时掌握消费动态,避免超额
 MikuMikuDance软件下载手机版汉化安装(MMD模型)v5.4安卓最新版
MikuMikuDance安卓汉化版,专为手机用户打造,支持MMD模型导入与编辑,轻松制作3D动画。操作简单,功能强大,免费下载,适合MMD爱好者随时创作。
 软天空最新版本2026下载v8.7.3 安卓版31.8M
 游咔盒子app手机版下载v5.0.8 2026手机版53.0M
 vivo应用商店免费下载安装2026v10.5.0.7最新版67.7M
 华为应用商店app下载2026最新版v16.7.1.300官方版54.9M
 google play商店2026官方版v53.3.21安卓正版90.6M
 猪猪软件库3.5下载2026官方最新版本v3.5安卓版6.3Mvivo应用商店v10.5.0.7 官方正版下载45M
 APKpure官方下载2026最新版v3.20.7803安卓官方最新版23.4M
 木瓜玩游戏盒子免费版下载v1.1海量游戏资源库5.8M
 apkpure官方下载v3.20.7803 2026最新安卓版19.9M
声明:289手游网为非盈利性网站 不接受任何赞助和广告
Copyright 2012-2026 289.com ALL Rights Reserved. 289手游网 版权所有 版权投诉请发邮件到tousu289@163.com,我们会尽快处理






 大小: 114.5M
 大小: 277.9M
 秦务员app下载2026最新版生活
 浙里办app官方下载2026手机版生活
 抖音极速版免费下载2026最新版社交
 江西赣服通app生活
 美团众包工具
 爱山东下载app官方最新版生活
